
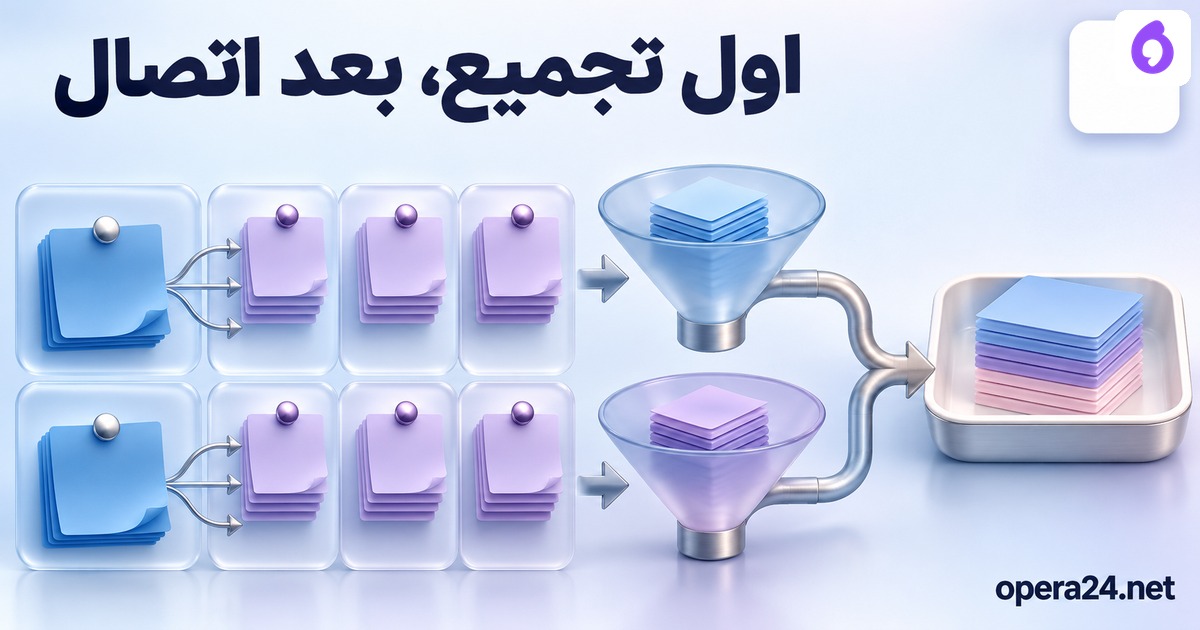
وقتی دو رابطهٔ یکبهچند را مستقیم به یک والد JOINمیکنیم، ردیفهای فرزند میتوانند یکدیگر را تکثیر کنند. SUMروی این خروجی دیگر الزاماً جمعِ واقعیِ هر رابطه نیست. این تمرین یک درخواست با دو یادداشت و سه تلاش را واقعاً به شش ردیف تبدیل میکند و نشان میدهد چرا COUNT DISTINCTیاSUM DISTINCTهرکدام فقط بخشی از مسئله را پوشش میدهند.
واحدِ داده را پیش از query بنویسیم
جدولِ requestدو والدِ۱و۲دارد. والدِ۱دو noteبا شناسههای۱۱و۱۲دارد که هر دو amountِ۱۰دارند؛ اینها دو رکوردِ مستقلاند، نه تکرارِ اشتباهیِ یک رکورد. سه attemptِ۲۱تا۲۳هم بهترتیب۲،۳و۴واحدِ ثانیهٔ ساختگی دارند. والدِ۲هیچ فرزندی ندارد.
amountدر این مثال واحدِ عددیِ آموزشی است و مبلغِ واقعیِ فاکتور یا فروش نیست. مرجعِ مستقل از خودِ فهرستهای Pythonمحاسبه میشود: دو noteبا جمع۲۰و سه attemptبا جمع۹. کلِ SQLiteحافظهای است؛ از پایگاهِ مشتری یا ساختارِ داخلیِ اپرا استفاده نکردهایم.
دو در سه، شش ردیف میشود
LEFT JOINِ اول هر noteرا به والدش میچسباند؛ LEFT JOINِ دوم برای هرکدام، سه attemptِ همان والد را هم میآورد. پس noteِ۱۱سه بار وnoteِ۱۲هم سه بار دیده میشود. هر attemptهم کنارِ دو noteتکرار میشود. فایلِ نتیجه هر شش ترکیبِ شناسه را واقعاً فهرست میکند تا فقط به عددِ aggregate تکیه نکنیم.
در queryِ غلط، SUMِ noteها۶۰وSUMِ ثانیهها۱۸میشود، در حالی که ورودی عوض نشده است. COUNTِ شناسهٔ noteوattemptهم هر دو۶میشود. این افزایش، رشدِ فعالیت یا سه برابر شدنِ نتیجهٔ مشتری نیست؛ اثرِ دانهبندیِ میانیِ queryاست.
چرا DISTINCT درمانِ عمومی نیست؟
| روشِ اجرا | تعدادِ note/attempt | جمعِ note/ثانیه |
|---|---|---|
| JOINمستقیم وaggregate | ۶و۶ | ۶۰و۱۸؛نادرست |
| COUNT DISTINCTِ شناسه | ۲و۳؛درست | جمعِ عادی همچنان تکثیرشده است |
| SUM DISTINCTِ مقدار | مسئلهٔ جدا | ۱۰و۹؛جمعِ noteغلط است |
| پیشتجمیعِ هر فرزند | ۲و۳ | ۲۰و۹؛برابرِ مرجع |
COUNT(DISTINCT n.id)برای شمارشِ همان شناسهها کار میکند، اما SUM(n.amount)را تعمیر نمیکند. SUM(DISTINCT n.amount)دو amountِ۱۰را به یک مقدارِ متمایز تبدیل میکند و۱۰میدهد؛ یکی از دو noteِ واقعی گم میشود. درستشدنِ جمعِ attemptدر این داده، بهدلیلِ متفاوتبودنِ۲و۳و۴است و تضمینِ روش نیست.
قبل از اتصال، هر رابطه را به دانهٔ والد برسانیم
در queryِ اصلاحشده، noteها با GROUP BY request_idبه یک ردیف برای هر والد تبدیل میشوند: تعداد وsumِ خودشان. attemptها هم مستقل همین کار را میکنند. سپس این دو خروجیِ یکردیفی به requestوصل میشوند؛ دیگر مجموعهٔ۲در۳ساخته نمیشود.
کد با CTEهای nsوatsهمین مسیر را اجرا و تمامِ خروجی را با مرجعِ دستساز و جمعِ مستقلِ Pythonبرابر میخواهد. نسخهٔ کاملِ queryدر فایلِ نتیجه هست. این الگو را بدونِ بررسیِ کلیدِ گروهبندی و قیودِ واقعی کپی نکنید؛ اگر هر CTEبرای یک والد چند ردیف بدهد، مشکلِ تکثیر میتواند برگردد.
والدِ بدونِ فرزند را پنهان نکنیم
LEFT JOINوالدِ۲را حفظ میکند. در خروجیِ خام، COUNT(*)برای آن۱است، چون یک ردیفِ گسترشیافته با خانههای NULLداریم؛ COUNTِ شناسهٔ فرزند صفر است. بنابراین تعدادِ ردیفِ خروجی را تعدادِ فرزند ننامید. در queryِ نهایی فقط شمارِ فرزندانِ ناموجود را طبق قرارداد با۰نشان میدهیم.
جمعِ noteوattemptبرای والدِ بدونِ فرزند NULLمیماند؛ آن را «اندازهگیریِ صفر» معرفی نکردهایم. اگر دامنهٔ شما جمعِ مجموعهٔ خالی را صفر میخواهد، این تصمیم باید صریح و جدا از خطایِ fan-outباشد. پُرکردنِ همهٔ NULLها مشکلِ دانهبندی را حل نمیکند و ممکن است شکافِ داده را بپوشاند.
به گزارشِ تماس برگردیم
مدلِ تلاش و مکالمه واحدهای کسبوکار را جدا میکند؛ اینجا حتی با شناسههای درست، JOINِ دو فرزند عدد را خراب کرد. در اتصالِ رکوردِ برداری به منبع یک پیوندِ منبعِ یکتا مطرح است؛ ضربِ دو مجموعهٔ فرزند مسئلهٔ مستقلِ این صفحه است.
برای بررسیِ گزارش در اپرابین، واحدِ شمارش، کلیدها و چند انتظارِ قابلحساب را همراهِ درخواستِ بررسی مطرح کنید. این تمرین نتیجهٔ گزارشِ واقعیِ اپرا را زیر سؤال نمیبرد یا تأیید نمیکند؛ نشان میدهد چطور یک خطای مشخصِ محاسبه را با دادهٔ ساختگی پیدا کنیم، بدون تماس، بارگذاری یا تغییرِ سامانهٔ اصلی.
فایل تمرین و منبع
کدِ کاملِ محلی و کنترلهای اصیلِ تمرین · دادهٔ ساختگی و خروجیِ اجرای واقعی
- SQLite SELECT،بخش۲٫۱و۲٫۳، ترکیبِ رابطهها،ONوLEFT JOIN؛ فقط بخشهای مرتبط خوانده شدند
- SQLite،تعریفِ DISTINCTدرaggregateوCOUNT/SUM؛ بخشهای مرتبط خوانده شدند
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.