
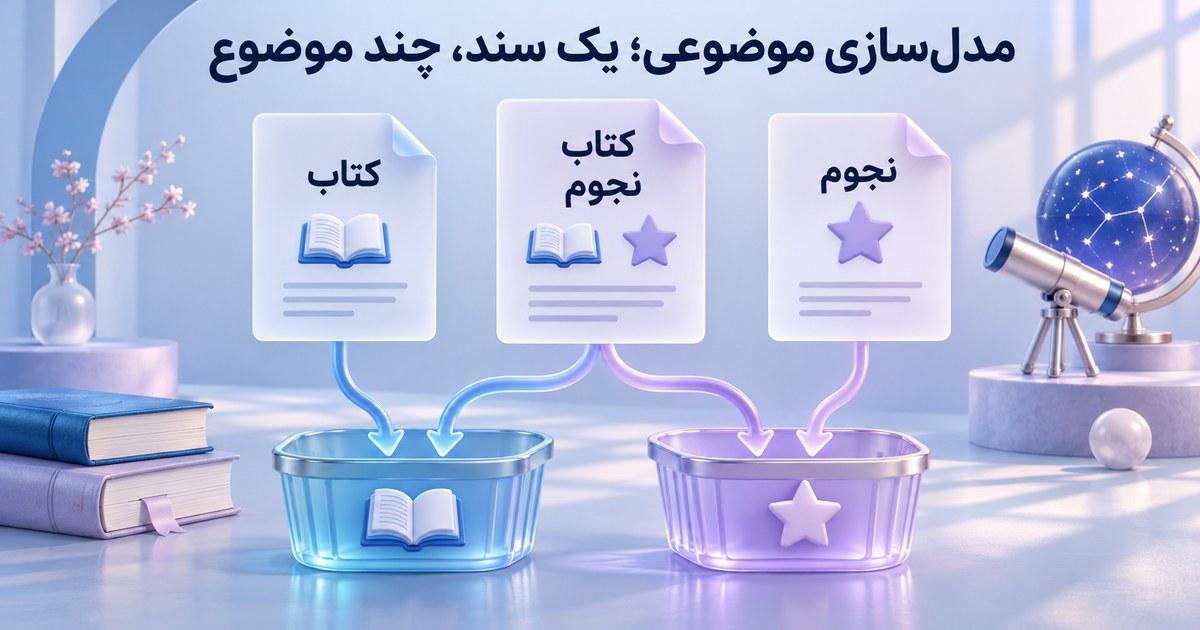
مدلسازی موضوعی به دنبال الگوهای موضوعی در مجموعهٔ متنهاست، معمولاً بدون اینکه برای هر متن از قبل برچسب موضوع بدهیم. خروجی میتواند وزن موضوعها در سند و واژههای برجستهٔ هر موضوع باشد؛ نامی مثل «نجوم» معمولاً تفسیر انسانیِ آن الگوست. این نام را از روی چند واژه به حقیقت قطعی دربارهٔ کل سند تبدیل نکنید.
سه سند بسیار کوچک را به جدول ببریم
برای آموزش، فقط چهار واژهٔ کتاب، امانت، ستاره و سیاره را نگه داشتهایم. جدول زیر شمارش ساختگی سه سند است؛ نه مجموعهٔ نمایندهٔ فارسی و نه خروجی تحلیل تماس واقعی. سند۱ فقط واژههای کتاب و امانت، سند۲ واژههای ستاره و سیاره، و سند۳ هر دو گروه را دارد.
| سند | کتاب | امانت | ستاره | سیاره |
|---|---|---|---|---|
| D1 | 2 | 2 | 0 | 0 |
| D2 | 0 | 0 | 2 | 2 |
| D3 | 1 | 1 | 1 | 1 |
این نمایش، ترتیب جمله و معنی کامل را نگه نمیدارد. جملهٔ «کتاب امانت ندهید» و «کتاب امانت بدهید» ممکن است در چنین واژگان محدودی بسیار شبیه دیده شوند؛ پس وزن واژه بهتنهایی تصمیم عملیاتی را مشخص نمیکند.
دو ماتریس چه چیزی را نشان میدهند؟
یک نمایش آموزشیِ شبیه ساختار NMF انتخاب میکنیم: H وزن واژهها برای دو مؤلفه و W وزن مؤلفهها در سه سند است. این عاملها را خودمان ساختهایم و الگوریتم برازش NMF اجرا نشده است.
H = [[1,1,0,0],   # مؤلفهٔ اول: کتاب، امانت
     [0,0,1,1]]   # مؤلفهٔ دوم: ستاره، سیاره
W = [[2,0],       # سند۱
     [0,2],       # سند۲
     [1,1]]       # سند۳
ضرب W×H دقیقاً همان جدول شمارش مثال را میدهد. در دادهٔ واقعی، NMF معمولاً عاملهایی را با کمینهکردن خطای بازسازی پیدا میکند و برابری دقیقِ مثال ما انتظار عمومی نیست. این وزنها نیز لزوماً احتمال یا درصد نیستند؛ W سند۱ جمع۲ دارد، نه۱. نرمالسازی برای نمایش سهم، قراردادی تازه است که باید نام و محدودیتش روشن باشد.
سند چندموضوعی با خوشهٔ تکانتخابی فرق دارد
سند۳ وزن۱برای هر دو مؤلفه دارد. مجبورکردن آن به فقط یک موضوع، بخشی از همین نمایش را حذف میکند. نامگذاری «کتاب و امانت» و «نجوم» پیشنهاد تفسیری ماست؛ برای نام واقعی باید سندهای دارای وزن بالا، موارد مخلوط و نمونههای خلاف برداشت را بخوانید. شمارهٔ مؤلفه هم هویت دائمیِ موضوع نیست؛ جابهجایی ستونهای W و سطرهای H بازسازی را عوض نمیکند، که کد همراه واقعاً آن را بررسی کرده است.
پایداری خوشهها دربارهٔ مقایسهٔ تقسیمبندی است و همان سؤال مدل موضوعی نیست. همچنین برچسب اصلی و فرعی تماس سیاست ازپیشتعریفشدهٔ کسبوکار را توضیح میدهد؛ موضوع کشفشدهٔ بیبرچسب را بیواسطه جای برچسب مصوب عملیاتی نگذارید.
چطور یک خروجی واقعی را بازبینی کنیم؟
- نسخهٔ متن، واژگان، حذف واژهها و تعداد مؤلفهها را ثبت کنید؛ تغییر آمادهسازی میتواند موضوعها را عوض کند.
- واژههای برجسته را همراه متنهای نمونه بخوانید. نامی که فقط از یک کلمه آمده، ممکن است بیش از حد کلی باشد.
- اجرای دیگر یا تنظیم کنترلشده را با نمونههای ثابت مقایسه کنید و ثبات را از مفیدبودن معنایی جدا نگه دارید.
- متن کوتاه، نفی، نام خاص و سند چندموضوعی را در بازبینی نگه دارید؛ تکرار چند واژهٔ سازمانی میتواند موضوع ظاهری بسازد.
روشهای موضوعی یکسان نیستند؛ LDA در این زمینه به Latent Dirichlet Allocation اشاره دارد و با Linear Discriminant Analysis همنام اختصاری است. این مقاله کد برازش هیچکدام را اجرا نمیکند. JSON و Python پایین صفحه فقط مثال دو مؤلفهای، بازسازی و جابهجایی شناسهها را دارند. مسیر ادامهٔ مبانی در صفحهٔ هوش مصنوعی است و این تمرین قابلیت تحلیل موضوعی محصول اپرا را اعلام نمیکند.
فایل تمرین و منبع
سه سند، چهار واژه و دو مؤلفهٔ ساختگی؛ JSON · کد محلی بازسازی و جابهجایی شناسهٔ موضوع
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.