
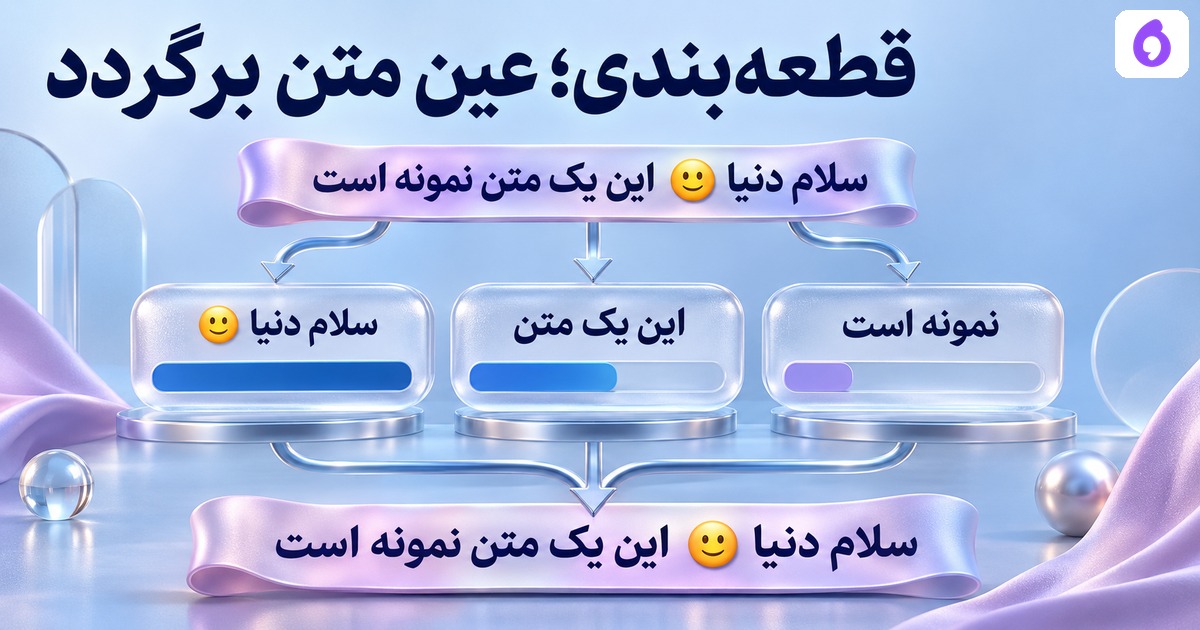
برای تقسیمِ متنِ طولانیِ TTS، تعدادِ حرف بهتنهایی کافی نیست؛ محدودیتِ بعضی سرویسها برحسبِ بایتِ UTF-8 است. راهِ قابلبررسی این است که سقفِ همان درخواست را معلوم کنیم، متن را در مرزهای اعلامی تقسیم کنیم و ثابت کنیم چسباندنِ قطعهها دقیقاً متنِ اولیه را میسازد. این تمرین با بودجهٔ ساختگیِ۲۴بایت همین کار را واقعاً اجرا میکند.
سقفِ فروشنده را از بودجهٔ تمرین جدا کنیم
صفحهٔ رسمیِ سهمیهٔ Google Cloud Text-to-Speech، هنگام بررسیِ۴نوامبر۲۰۲۶، برای محتوای هر درخواست سقفِ۵۰۰۰بایت را بیان میکند؛ تاریخِ بهروزرسانیِ دیدهشده۲۶اکتبر۲۰۲۶ است. این عدد متعلق به همان سرویس و دامنهٔ مستند است، نه تعرفه یا محدودیتِ اپراگو و نه تضمینِ همهٔ موتورهای گفتار.
در فایل ما budget یک ورودیِ صحیحِ مثبت است. مقدارِ۲۴ را عمداً کوچک انتخاب کردهایم تا مرزها دیده شوند؛ هیچ درخواستِ Google یا تولیدِ صدایی انجام نشده است. پیش از استفادهٔ واقعی، مدل، نوعِ ورودی و محدودیتِ جاریِ ارائهدهندهٔ خودتان را بررسی کنید؛ سقفِ تعدادِ درخواست با سقفِ محتوای یک درخواست فرق دارد.
اول سیاستِ مرز را صریح کنیم
این نسخه متنِ ساده را به دنبالههای فاصله و دنبالههای غیرِفاصله جدا میکند. قطعهها با حفظِ ترتیب تا بودجه پُر میشوند؛ یک واژهٔ بدون فاصله وسطش بریده نمیشود. اگر خودِ آن توکن از سقف بزرگتر باشد، خطا میدهیم تا تصمیمِ تازه گرفته شود. کد مدعیِ تشخیصِ جمله، واژهشناسیِ فارسی یا حفظِ آهنگِ گفتار نیست.
فاصله، خطِ جدید و فاصلههای ابتدا و انتها حذف نمیشوند. اگر یک دنبالهٔ خیلی بلندِ فاصله از سقف بگذرد، در مرزِ code point تقسیم میشود. این سیاست، قطعهبندیِ جامعِ grapheme برای همهٔ زبانها نیست. نیمفاصلهٔ داخلِ واژه در همان توکن میماند؛ اگر کلِ آن توکن جا نشود، رد میشود و پنهانی شکسته نمیشود.
سه قطعهٔ واقعیِ مثال
ورودیِ اصیل با دو فاصله آغاز میشود، «سلام»، یک ایموجی، «میرویم.»، خطِ جدید و یک سطرِ دیگر دارد؛ در پایان هم دو فاصله باقی میماند. فایلِ نتیجه متنِ دقیق را با escapeهای روشن نگه میدارد تا چشم، فاصلهها را گم نکند. خروجیِ سه قطعه بهترتیب۱۷،۲۴و۲۱بایت دارد؛ هیچکدام از بودجهٔ۲۴بایت عبور نکردهاند.
| قطعه | حجمِ UTF-8 | چیزی که حفظ میشود |
|---|---|---|
| آغاز تا پس از ایموجی | ۱۷بایت | دو فاصلهٔ اول و فاصلههای اطراف ایموجی |
| میرویم و آغاز سطر بعد | ۲۴بایت | نیمفاصله و خطِ جدید |
| ادامهٔ سطر تا پایان | ۲۱بایت | حرفِ دارای علامتِ ترکیبی و فاصلهٔ انتهایی |
بازسازی را با چه شاهدی میسنجیم؟
برای هر قطعه، بازهٔ code point و بازهٔ بایتِ شروع و پایانِ خارج از بازه ثبت میشود. هشِ SHA-256ِ همان قطعه و کلِ متن هم داریم. کنترلِ اصلی این است که joinِ بدون جداکنندهٔ تازه، دقیقاً برابر با ورودی باشد؛ افزودنِ خودکارِ فاصله بین قطعهها این شرط را میشکند.
عددِ حجم از encode واقعیِ UTF-8 میآید، نه از ضربِ تعدادِ حروف در یک ضریب. کد هم برابریِ متنِ بازسازیشده و هم سقفِ تمامِ قطعهها را assert میکند. این شاهدِ حفظِ متن است؛ دربارهٔ ترتیبِ پاسخهای یک API، چسباندنِ فایل صوتی یا کیفیتِ گذرِ میان دو قطعه چیزی ثابت نمیکند.
حالتهای مرزی را اجرا کنیم
متنِ خالی فهرستِ خالی میدهد. پنجاه فاصله با بودجهٔ۷ به قطعههای درونِ سقف تبدیل و دقیقاً بازسازی میشود. یک واژهٔ بیشازحدِ سقف، budget بولی، ورودیِ اعلامشده بهعنوانِ SSML و surrogate نامعتبر واقعاً رد میشوند. ردِ SSML عمدی است؛ شکستنِ XML با همین الگوریتم ممکن است تگِ باز یا ساختارِ نامعتبر بسازد.
برای کارِ واقعی اگر واژه یا جملهٔ بلند جا نمیشود، متن و سقف را بازبینی کنید یا الگوریتمِ مناسبِ قالب را جدا طراحی کنید. این فایل راهِ دورزدنِ سهمیه نیست، موازیسازیِ درخواست انجام نمیدهد و هیچ مصرفِ هزینهداری نمیسازد. حتی متنِ کاملاً سالم میتواند پس از تبدیل، مکث یا لحنِ نامناسب داشته باشد و به شنیدنِ همان صوت نیاز داشته باشد.
از شمارش تا تحویلِ درست
شمارندهٔ طولِ فارسی واحدها را نشان میدهد؛ اینجا تقسیمِ قابلبازسازی و قراردادِ مرز داریم. کنترلِ ورودی SSML هم مالکِ ساختارِ نشانهگذاری است و جای آن را این قطعهبند نمیگیرد.
برای درخواستِ اپراگو، متنِ نمونه، نوعِ کاربرد و خروجیِ مورد انتظار را آماده کنید. سقفِ ورودی و روشِ تحویل را با تیم مشخص کنید؛ وجودِ قطعهبند یا APIِ مشابهِ Google در اپراگو از این مثال نتیجه نمیشود. فایل برای بررسیِ فنیِ معیارِ حفظِ متن است.
فایل تمرین و منبع
کد کامل تمرین محلی و کنترلهای ورودی · دادهٔ ساختگی و خروجیِ اجرای واقعیِ تمرین
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.