
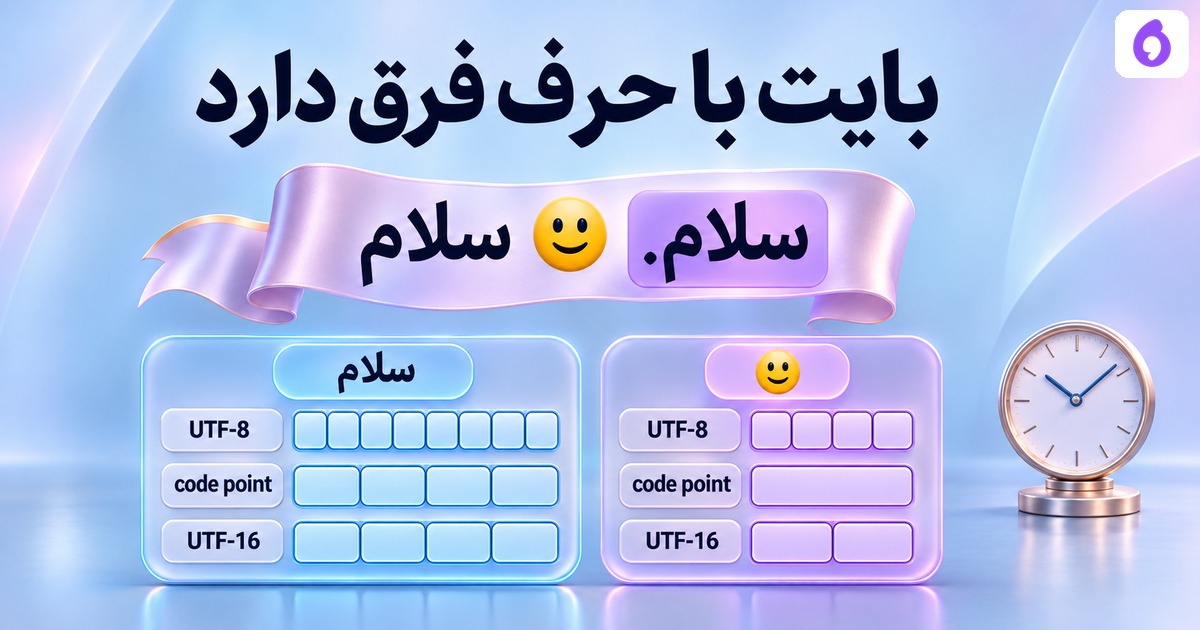
اگر هایلایتِ کلمه در متنِ فارسی جابهجا میشود، اول واحدِ start وend را بررسی کنید. در speech markِ مستندِ Amazon Polly این دو مقدار بایتِ متنِ ورودیاند؛ اندیسِ حرف یا زمانِ صدا نیستند. این صفحه روی یک متنِ فارسیِ دارای ایموجی و کلمهٔ تکراری، برشِ درست و خطای تبدیلِ واحد را با کد محلی نشان میدهد.
مثال کاملاً دستساز است
متنِ تمرین «سلام 🙂 سلام.» است. دو ردیفِ line-JSON را خودمان نوشتهایم: سلامِ اول time=۰،start=۰،end=۸؛ سلامِ دوم time=۷۰۰،start=۱۴،end=۲۲ دارد. عدد۷۰۰زمانِ ساختگی به میلیثانیه است؛ هیچ صدایی تولید یا پخش نشده و این ردیفها خروجیِ AWS، اپراگو یا موتورِ فارسی نیستند.
قراردادِ محلی، شروع را شامل و پایان را خارج از بازه میگیرد. ابتدا متن را دقیقاً با UTF-8 به بایت تبدیل میکنیم؛ سپس bytes[۱۴:۲۲] باید به همان رخدادِ دومِ «سلام» تبدیل شود. یک فاصله، ایموجی و فاصلهٔ بعدی، جایِ بایتی را از تعدادِ نویسهها جدا کردهاند. جستوجوی اولین «سلام» جایِ رخدادِ دوم را نمیدهد.
چهار عدد که نباید جای هم مصرف شوند
| مقدارِ سلام دوم | شروع | پایانِ خارج از بازه |
|---|---|---|
| بایتِ UTF-8 | ۱۴ | ۲۲ |
| code point پایتون | ۷ | ۱۱ |
| واحدِ UTF-16 برای این متن | ۸ | ۱۲ |
ایموجیِ این مثال یک code point و دو واحدِ UTF-16 دارد؛ بنابراین حتی پس از حلِ اختلافِ بایت و حرف، اندیسِ مناسبِ محیطِ نمایش هم باید تعیین شود. عددِ time در هیچیک از این بازهها قرار نمیگیرد؛ موقعیتِ ادعایی در صوت است و برای کنترلش فایلِ همان تولید لازم است.
مرزِ بایت را پیش از برش کنترل کنیم
validator فقط پذیرفتنِ start کوچکتر ازend را کافی نمیداند. پیشوندِ متن تا start وend باید UTF-8 معتبر باشد تا برش وسطِ توالیِ چندبایتی نیفتاده باشد. تغییرِ startِ دوم به۱۵ واقعاً رد میشود؛ این عدد وسطِ حرفِ فارسی است. بریدنِ رشتهٔ پایتون با۱۴هم راهحل نیست، چون آن اندیس اصلاً بایتی نیست.
پس از کنترلِ مرز، زیررشته با valueِ همان ردیف مقایسه میشود. مقدارِ نادرست، بازهٔ خارج از طولِ متن و نسخهٔ تغییرکردهٔ متن هرکدام خطای مستقل میدهند. هشِ SHA-256ِ متنِ دقیق همراه خروجی ثبت میشود؛ تغییرِ فاصله یا نشانهگذاری بدون تولید و تطبیقِ دوباره مجاز فرض نشده است.
زمانِ mark چه چیزی را ثابت نمیکند؟
کد، timeهای صحیحِ غیرمنفی و ترتیبِ آنها را کنترل میکند؛ این فقط سازگاریِ دادهٔ آموزشی است. بدون صوت، درستیِ۷۰۰میلیثانیه، شنیدهشدنِ کلمه، مکث، تلفظ یا همگامیِ واقعیِ هایلایت ثابت نمیشود. حتی عبورِ همهٔ آزمونهای این فایل را تستِ کیفیتِ TTS ننامید.
مستندِ Polly هشدار میدهد metadata میتواند میان صداهای مختلف فرق کند؛ markِ یک تولید را صرفاً به صدای دیگر نچسبانید. نوعِ mark هم مهم است: فایلِ محدودِ ما فقط word روی متنِ ساده را میپذیرد و SSML را رد میکند. معنایِ offset و پایانِ بازه را برای سرویسِ دیگر از مستند همان سرویس بگیرید.
اجرای تمرین و خطاهای واقعی
فایلِ Python فقط کتابخانهٔ استاندارد میخواهد. demo متن و ردیفهای دستساز را میسازد، هر دو رخداد را استخراج میکند و اندیسهای code point وUTF-16 را گزارش میدهد. سپس برشِ داخلِ UTF-8، متنِ تغییرکرده، valueِ ناسازگار، end=۹۹۹ و ورودیِ SSML را واقعاً میآزماید؛ این موارد در خروجی رد شدهاند.
در یک سامانهٔ واقعی، متنِ اولیه، تنظیمِ صدا و شناسهٔ تولیدِ همان صوت را با مجوزِ لازم نگه دارید. دادهٔ مشتری برای تمرینِ عمومی لازم نیست؛ نمونهٔ ساختگی کفایت میکند. فایلِ حاضر هیچ API، اتصالِ صوتی، بارگذاری یا مصرفِ هزینهدار ندارد و به دادهٔ خصوصی دست نمیزند.
جای این کنترل در تحویلِ گویندگی
شمارشِ طولِ متن فارسی فرقِ واحدها را توضیح میدهد؛ اینجا یک رخدادِ مشخصِ کلمه را با بازه و هش به همان متن برمیگردانیم. همترازیِ متن و صوت هم مسئلهٔ دیگری است و با markِ دستساز انجام نشده است.
برای درخواستِ اپراگو، کاربردِ متنِ زماندار و محیطِ نمایش را روشن کنید و دربارهٔ خروجیِ قابلتحویل توافق بگیرید. این راهنما وجودِ speech mark، API مشابهِ Polly یا همگامیِ آماده در اپراگو را وعده نمیدهد؛ فقط معیارِ کنترلِ یک قرارداد را ارائه میکند.
فایل تمرین و منبع
کد کامل تمرین محلی و کنترلهای ورودی · دادهٔ ساختگی و خروجیِ اجرای واقعیِ تمرین
- مستندِ اصلی Amazon Polly؛ تعریفِ فیلدهای speech mark، واحدِ بایت و میلیثانیه و وابستگی به صدا؛ ردیفهای مثال ساختهٔ تحریریهاند
- مرجع SynthesizeSpeech؛ متنِ UTF-8 و نوعِ ورودی؛ فقط بخشِ مرتبط خوانده شد و API اجرا نشد
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.