
معادلهٔ بلمنِ بهینگی میگوید ارزشِ یک وضعیت با بهترینِ انتخابِ مجموعِ پاداشِ فوری و ارزشِ تنزیلشدهٔ آینده سازگار باشد. Value Iteration ازاین رابطه برایِ بهروزرسانیِ مقدارها استفاده میکند. اینجا مدلِ انتقال ازقبل معلوم است و احتمالِ دو پیامد را جمع میکنیم؛ تجربهٔ نمونهگیریشده یا یادگیری از تماسِ واقعی نداریم.
مدلِ کوچک، پاداش و پایان
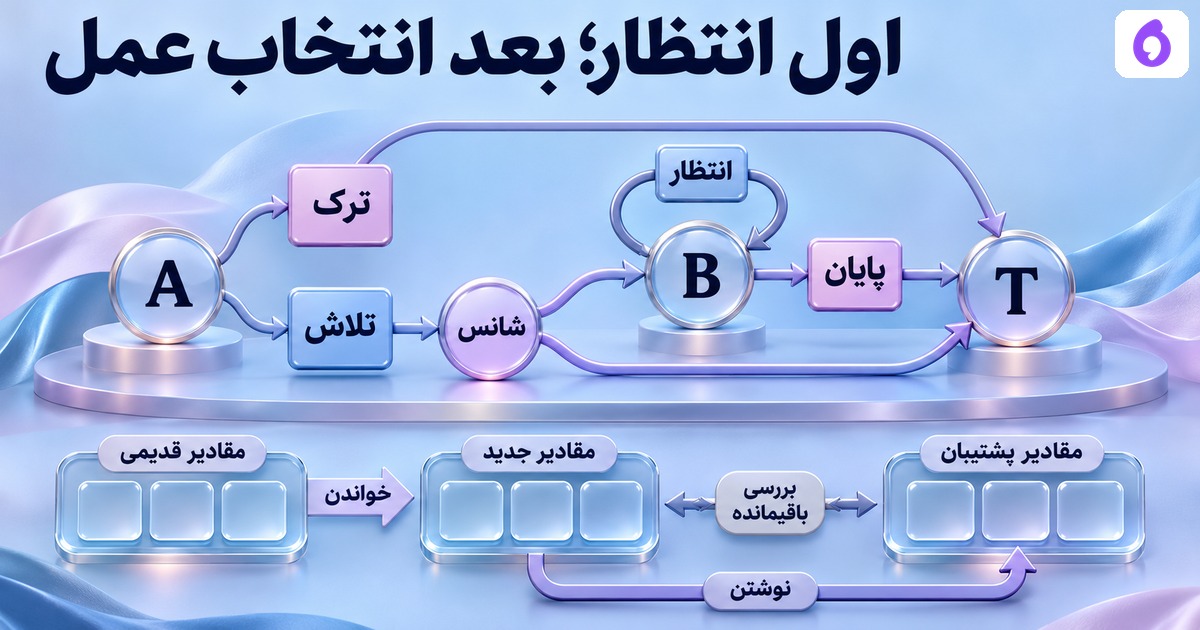
سه وضعیتِA،BوTداریم وTپایانی است. درA، عملِquitقطعاً بهTبا پاداش۱میرود. عملِtryبا احتمالِ۱÷۲بهBوپاداش۰و با احتمالِ۱÷۲بهTوپاداش۴میرود. درB، finishقطعاً بهTبا پاداش۳وwaitبهخودِBبا پاداش۱میرود. این اعداد قراردادی و آموزشیاند، نه سودِ واقعیِ کسبوکار.
پاداش مربوط به هر انتقال است؛ پاداشِ ورود بهTهمان یک بار حساب میشود وپس ازآن عملی نداریم، پس V(T)=۰است. ضریبِ تنزیل γ=۱÷۲را ثابت گرفتهایم. مدل، مجموعهٔوضعیتها و احتمالها وپاداشها را خودمان نوشتهایم؛ تخمینِپارامتر ازداده انجام نشده است.
بهروزرسانیِ همزمان چه معنی دارد؟
Q_k(s,a) = sum_next P(next|s,a) * [reward(s,a,next) + gamma*V_k(next)]
V_next(s) = max_action Q_k(s,a)
درهر جاروب، همهٔ وضعیتها باید ازیک نسخهٔ قدیمیِVبخوانند؛ خروجی دریک دیکشنریِجدید نوشته میشود. ابتدا V₀برایِهرسه وضعیت صفر است. برنامه ترتیبِ پردازشِوضعیتها را هم برعکس میکند و برابریِ نتیجه را کنترل میکند. استفاده ازمقدارِ تازهٔ یک وضعیت درهمان دور، اجرایِهمزمانِاین قرارداد نیست؛ ممکن است روشِدرجایِمعتبری باشد، اما دفترِ متفاوتی میسازد.
جاروبِ اول: هنوز ارزشِ آینده صفر است
درA، quitعدد۱وtryعدد(۱÷۲)×۰+(۱÷۲)×۴=۲میدهد؛ پس V₁(A)=۲. درB، finishعدد۳وwaitعدد۱میدهد؛ پس V₁(B)=۳. وضعیتِTصفر میماند. ما بیشترینِ پیامدِ تصادفی را انتخاب نکردهایم؛ اول انتظارِ پیامدهایِهرعمل را جمع و بعد بینِعملها maxگرفتهایم.
جاروبِ دوم: آینده به انتخابِ امروز وارد میشود
این بار tryدرA برابرِ(۱÷۲)×(۰+۰٫۵×۳)+(۱÷۲)×(۴+۰٫۵×۰)=۲٫۷۵است. quitهمان۱میماند؛ پس V₂(A)=۱۱÷۴. درB، waitبرابرِ۱+۰٫۵×۳=۲٫۵وfinishبرابرِ۳است؛ پس V₂(B)=۳. فایل، Qِتمامِعملها را ازنسخهٔقبلی نگه میدارد، نه فقط عملِبرنده را.
| نسخه | V(A) | V(B) | V(T) |
|---|---|---|---|
| V₀ | ۰ | ۰ | ۰ |
| V₁ | ۲ | ۳ | ۰ |
| V₂ | ۱۱÷۴ | ۳ | ۰ |
residual را رویِ همان Vِگزارششده بسنجیم
پس ازدو جاروب، یک backupِتازه B(V₂)حساب و باV₂مقایسه میشود. بیشترینِ قدرمطلقِ اختلاف، residualِبلمنِ نرمِبینهایت است ودراین مثال دقیقاً صفر میشود. ولی اجرایِ جدا با سقفِیک جاروب، V₁را میدهد وresidualآن۳÷۴است؛ تمامشدنِبودجهٔگام را همگرایی ننامیدهایم.
درمدلِمتناهی باپاداشِکراندار وγکمتر ازیک، عملگرِبلمن انقباضی است؛ بااینحال رسیدنِدقیق به نقطهٔثابت پس ازدو جاروب ویژگیِهمین داده است. تعدادِثابتی ازجاروبها را برایِهرMDPکافی اعلام نمیکنیم. کدFractionاست؛ تلرانسِممیزشناور یا مسئلهٔتقریبِحالتِپیوسته را آزمایش نکردهایم.
سیاست را از Vِنهایی استخراج کنیم
با V₂، بهترینِعمل درAهمانtryو درBهمانfinishاست؛ برایِTعملی نداریم. برایِکنترلِمستقل، چهار سیاستِقطعیِثابت را نیز مستقیم حل میکنیم. اگرBهمیشهwaitکند، ارزشش۱÷(۱−۰٫۵)=۲است؛ اگرfinishکند۳است. درA، quitارزش۱وtryارزشِ۲+۰٫۲۵V(B)دارد. این چهار حساب، بیشترینِمقدارهایِ۱۱÷۴و۳را تأیید میکنند.
ارزشِانتظاری با پاداشِهرمسیرِواقعشده یکی نیست. tryممکن است بهBیاTبرود؛ سیاستِبهینهٔمدل هم تضمینِیک پیامدِقطعی نمیدهد. اگر احتمالهایِمدل غلط باشند یا هدفِپاداش باخواستهٔواقعی فرق کند، درستبودنِمحاسبه کافی نیست.
مدلِ معلوم با Q-learning فرق دارد
بهروزرسانیِ Q-learning یک تجربهٔنمونه را واردِیک خانهٔجدول میکند؛ اینجا تمامِپیامدهایِمعلومِهرعمل را بااحتمالشان جمع کردهایم. وضعیت، عمل وپاداش نیز پیشنیازِتعریفِمسئله است. برایِنیازِپاسخگویی وپیگیری، کارِمجاز وشاهدِپذیرش را در راهکارهایِاپرا روشن کنید؛ این مثال به معماری یا سیاستِمحصول نسبت داده نمیشود.
فایل تمرین و منبع
مدلِ معلوم، دو جاروبِ همزمان و چهار سیاستِ مستقل؛ Python · همهٔ Qهایِ پشتیبان، Vِ گزارششده و residualِ تازه
- Berkeley CS188؛ updateِ همزمان، عملگرِبلمنِ تنزیلشده و استخراجِسیاست؛ مدل واعدادِاین صفحه اصیلاند
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.