
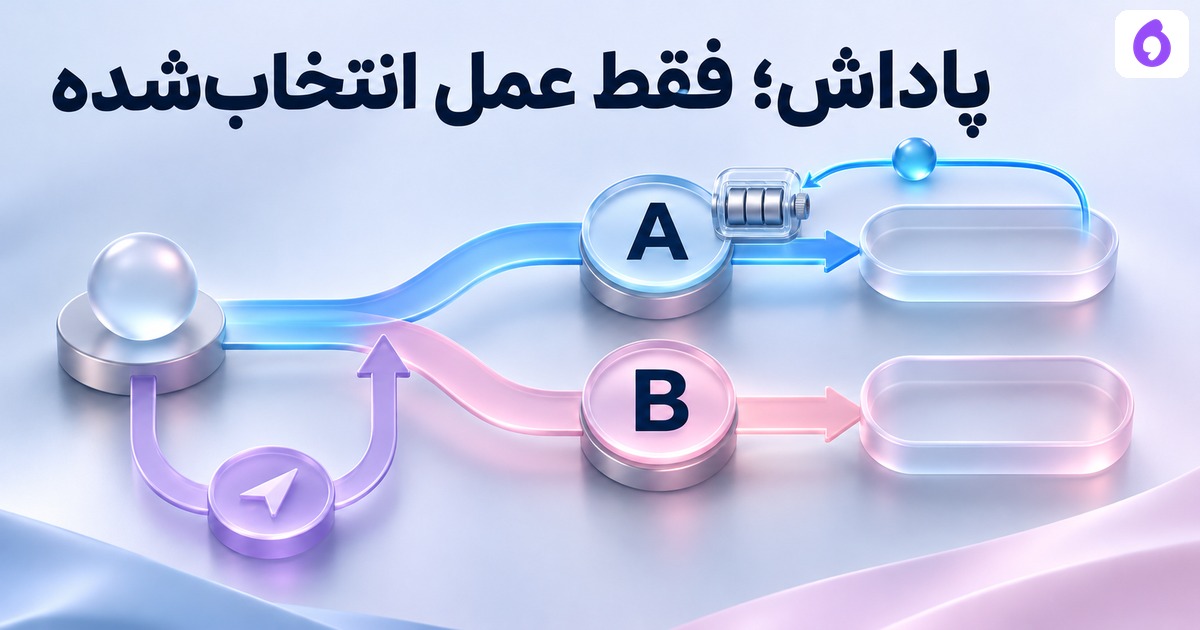
بندیتِ زمینهدار، برایِ زمینهٔ فعلی یک عمل انتخاب میکند و از پاداشِ همان عمل برایِ تصمیمهایِ بعدی میآموزد. خروجیِ عملِ انتخابنشده معمولاً مشاهده نمیشود. برایِ فهمِ اکتشاف و بهرهبرداری، یک شبیهسازِ کاملاً ساختگی با دو زمینه و دو عمل را شصت گام اجرا میکنیم؛ هیچ کاربر یا کلیکی در کار نیست.
محیطِ ساختگی را از سیاست جدا کنیم
دو زمینه با نامِ red و blue و دو عملِ A و B داریم. نامها فقط شناسهٔ آموزشیاند. در محیطی که نویسنده ساخته، احتمالِ پاداشِ یک در red برایِ A برابرِ ۰٫۸ و برایِ B برابرِ ۰٫۲ است؛ در blue این دو جابهجا میشوند. این نرخها نتیجهٔ آزمایش، فروش یا ترجیحِ واقعیِ مخاطب نیستند.
سیاست به جدولِ نرخهایِ حقیقیِ شبیهساز برایِ انتخاب دسترسی ندارد؛ میانگینِ پاداشهایِ مشاهدهشدهٔ هر جفتِ زمینه و عمل را نگه میدارد. چهار گامِ اول هر چهار جفت را یکبار بهاجبار میبیند تا مخرجِ میانگین صفر نباشد. از گامِ پنجم زمینهها یکیدرمیان میآیند؛ زمینهٔ بعد را عملِ فعلی تعیین نمیکند.
قاعدهٔ epsilon-greedy چه میکند؟
epsilon را ۰٫۲ گذاشتهایم. در شاخهٔ بهرهبرداری، عملی که میانگینِ فعلیِ بیشتری دارد انتخاب میشود؛ تساوی با ترتیبِ نامِ A پیش از B شکسته میشود. در شاخهٔ اکتشاف، یکی از دو عمل با احتمالِ برابر برگزیده میشود. کد این انتخاب و بهروزرسانی را واقعاً انجام میدهد؛ فهرستِ تصمیمها از قبل نوشته نشده است.
احتمالِ نهاییِ انتخابِ عملِ حریص در هر گامِ پس از گرمکردن ۰٫۹ است، چون هم شاخهٔ ۰٫۸ و هم نصفِ شاخهٔ ۰٫۲ میتوانند آن را انتخاب کنند. احتمالِ عملِ دیگر ۰٫۱ است. بنابراین رخدادنِ شاخهٔ اکتشاف الزاماً به انتخابِ عملِ غیرحریص نمیانجامد. برایِ چهار گامِ اجباری احتمالِ شرطیِ انتخاب یک ثبت شده است.
فقط پاداشِ انتخابشده واردِ یادگیری میشود
دو مولدِ تصادفیِ جدا با آغازگرهایِ ۷ و ۱۱ برایِ سیاست و محیط داریم. محیط فقط برایِ عملِ منتخب یک پاداشِ صفر یا یک میسازد. کد شمارنده و مجموعِ موفقیتِ همان خانه را اصلاح میکند و ثابتبودنِ خانهٔ عملِ دیگر را کنترل میکند. در هر گام، زمینه، عمل، علتِ شاخه، احتمالِ انتخاب و شمارندههایِ پیش و پس ثبت میشوند.
فایلِ JSON همهٔ شصت ردیف را دارد؛ جدولِ زیر خلاصهٔ شمارشِ واقعیِ همان اجراست. مجموعِ پاداشِ مشاهدهشده 41 است؛ این عدد فقط خروجیِ همین شبیهساز و آغازگرهاست.
| زمینه | عمل | تعدادِ انتخاب | پاداشِ یک |
|---|---|---|---|
| red | A | 25 | 20 |
| red | B | 5 | 0 |
| blue | A | 7 | 1 |
| blue | B | 23 | 20 |
پاداشِ ازدسترفته را از مشاهده اختراع نکنیم
چون سازندهٔ شبیهساز نرخها را میداند، فاصلهٔ امیدِ پاداشِ عملِ منتخب با بهترین نرخِ همان زمینه را جدا جمع زدهایم. این expected pseudo-regret از نرخهایِ معلومِ محیط میآید؛ پاداشِ واقعیِ دیدهنشدهٔ عملِ دیگر نیست. در دادهٔ عملیاتی، دانستنِ این نرخها خودکار فراهم نیست و از این فایل نتیجهٔ افزایشِ کلیک نمیگیریم.
در شصت گام، بهینهشدن یا همگراییِ همهٔ سیاستها ثابت نشده است. اکتشاف برایِ کاربردِ واقعی محدودیتِ مجوز، هزینه و اثرِ نامطلوب دارد. اینجا هیچ ارسال، پیشنهادِ واقعی یا تصمیم دربارهٔ مشتری انجام نشده و Vowpal Wabbit اجرا نشده است؛ منبعِ اصلی برایِ تعریفِ مسئله و احتمالِ انتخاب خوانده شده است.
با Q-Learning چه فرقی دارد؟
در بهروزرسانیِ جدول Q ارزشِ تخمینیِ وضعیتِ بعد در هدف وارد میشود. این مثال فقط پاداشِ فوریِ عملِ منتخب را میانگین میگیرد و bootstrap آینده ندارد. محیط و بازدهِ مسیر نیز مسئلهٔ دیگری است؛ وجودِ نامِ ایجنت ثابت نمیکند محصول با این روشها آموزش دیده است.
برایِ یک نیازِ واقعیِ پاسخگویی یا پیگیری، کارِ مجاز و معیارِ پذیرش را در راهکارهایِ اپرا مشخص کنید. این صفحه توضیحِ سازوکارِ یادگیری است؛ آزمایشِ رشد یا وعدهٔ انتخابِ خودکارِ بهترین پیام برایِ مشتری نیست.
فایل تمرین و منبع
شصت تصمیم، پاداشِ عملِ منتخب و بهروزرسانیِ میانگین · دفترِ واقعیِ زمینه، احتمالِ انتخاب، پاداش و شمارندههایِ پیش/پس
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.