
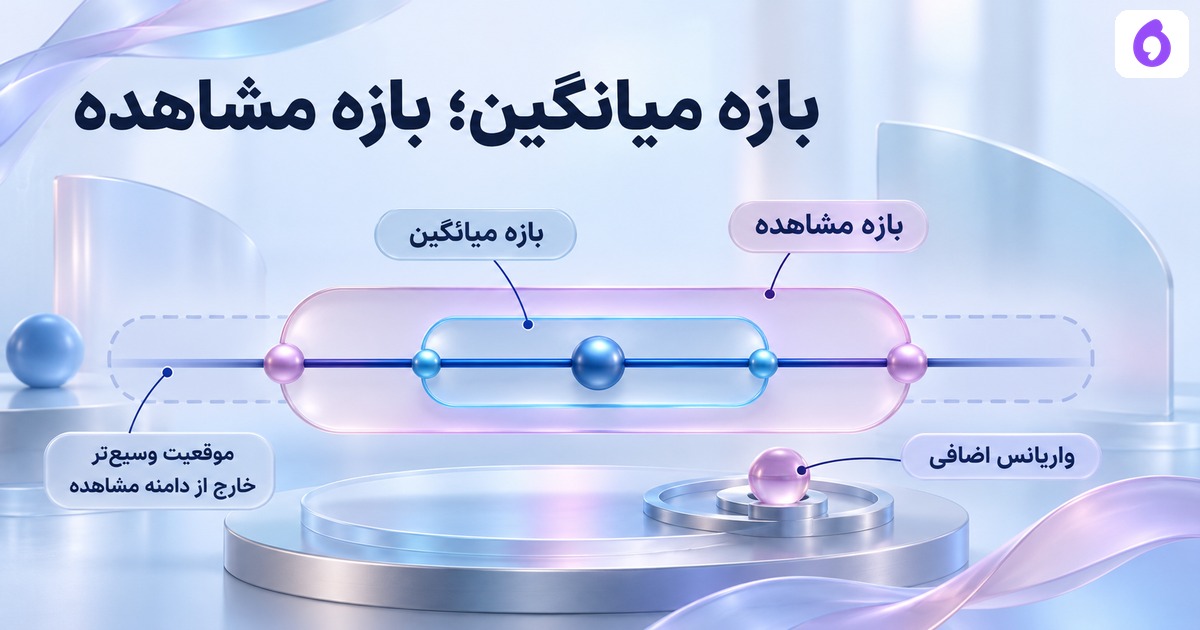
بازهٔ اطمینانِ میانگین و بازهٔ پیشبینیِ یک مشاهدهٔ تازه یک هدف ندارند. اولی عدمِ قطعیتِ تخمینِ میانگین را توصیف میکند؛ دومی علاوه بر آن، پراکندگیِ خودِ مشاهدهٔ تازه را هم در نظر میگیرد. برایِ دیدنِ این تفاوت، خطی را رویِ پنج نقطهٔ ساختگی برازش و هر دو بازه را با فرضهایِ کاملاً مشخص حساب میکنیم.
پنج نقطه و یک فرضِ مهم دربارهٔ نویز
xها منفیِ دو، منفیِ یک، صفر، یک و دو هستند و نویسنده y را برابرِ x+1 گذاشته است. کد کمترین مربعات را از میانگینها و مجموعِ حاصلضربها واقعاً حساب میکند؛ شیب و عرض از مبدأ هر دو یک و مجموعِ مربعِ فاصلههایِ x از میانگین، ده میشود. این خروجی از فراخوانیِ Statsmodels نیامده است.
برایِ نشاندادنِ فرمولِ بازهها، مدلِ خطیِ با خطاهایِ نرمالِ مستقل و انحرافِ معیارِ معلومِ یک را فرض میکنیم. این «معلوم» قراردادِ آموزشی است؛ از پنج نقطه برآورد نشده است. همهٔ نقاطِ دستساز رویِ خطاند و مجموعِ مربعِ باقیماندهٔ آنها صفر است؛ از این صفر نتیجه نمیگیریم نویزِ جهانِ واقعی صفر است یا انحرافِ معیارِ یک را داده تأیید کرده است.
عدمِ قطعیتِ میانگین از کجا میآید؟
برایِ محلِ تازهٔ x، مقدارِ h برابرِ 1/n+(x−meanX)²/Sxx است. در مدلِ خطی با X ثابت و واریانسِ معلومِ sigma²، واریانسِ تخمینِ میانگین sigma²×h میشود. این توزیع به تکرارِ فرضیِ نمونهگیری در همان مدل مربوط است؛ یک جدولِ دستساز بهتنهایی آن فرایند یا درستیِ فرضها را اثبات نمیکند.
در مرکزِ داده یعنی x=0، h برابرِ یکپنجم است. در x=3، h به یازدهدهم میرسد. فاصله از مرکزِ X در این فرمول عدمِ قطعیتِ تخمین را بیشتر میکند. در محلِ بیرون از دامنه، همین حساب همچنان به درستبودنِ امتدادِ خط وابسته است؛ بزرگترشدنِ بازه جایِ بررسیِ اعتبارِ برونیابی را نمیگیرد.
برایِ مشاهدهٔ تازه، یک جزء اضافه داریم
اگر خطایِ مشاهدهٔ آینده از تخمین مستقل و با همان واریانسِ معلوم باشد، واریانسِ خطایِ پیشبینی sigma²×(h+1) است. جزءِ اضافهٔ یک به پراکندگیِ مشاهدهٔ تازه مربوط است. در کدِ منبعِ رسمی هم خطایِ استانداردِ مشاهده از جمعِ واریانسِ میانگین و واریانسِ باقیمانده ساخته میشود؛ معنایِ این دو هدف جداست.
سطحِ اسمیِ بازهها ۹۵ درصد است. چون sigma را معلوم فرض کردیم، مقدارِ بحرانی را از نرمالِ استاندارد میگیریم. اگر واریانس از باقیماندهٔ یک مدلِ مناسب برآورد شود، مسئلهٔ درجهٔ آزادی و بازهٔ t مطرح میشود؛ آن حالت را با همین عددِ نرمال جایگزین نکردهایم.
دو محل و خروجیِ واقعیِ کد
| x | h | واریانسِ میانگین | واریانسِ مشاهده | بازهٔ میانگین | بازهٔ مشاهده |
|---|---|---|---|---|---|
| 0 | 1/5 | 1/5 | 6/5 | 0.1235, 1.8765 | -1.1470, 3.1470 |
| 3 | 11/10 | 11/10 | 21/10 | 1.9444, 6.0556 | 1.1597, 6.8403 |
در هر دو ردیف، بازهٔ مشاهدهٔ تازه پهنتر است؛ اختلافِ دو واریانس دقیقاً یک میشود. فایل، کسرهایِ h و واریانس را دقیق و کرانهایِ نرمال را عددی نگه میدارد. پهنایِ بیشتر، تضمینِ پوششِ واقعیِ یک خدمت، زمانِ پاسخ یا سفارشِ بعدی نیست.
چه چیزی با این فایل سنجیده نشده است؟
آزمونِ نرمالبودن، استقلال، درستبودنِ خط و ثابتبودنِ واریانس انجام نشده است. پوششِ تجربیِ بازهها رویِ دادهٔ جدا هم اندازهگیری نشده است. عددِ ۹۵ درصد سطحِ اسمی در چارچوبِ فرضهاست؛ احتمالِ شخصیِ قطعی برایِ همین مشاهدهٔ آینده یا شاهدِ پیشبینیِ محصول نیست.
بازهٔ بیزی و اطمینان دربارهٔ تفسیرِ دو روشِ استنباط است؛ اینجا تفاوتِ هدفِ میانگین و مشاهده را حساب کردیم. زیانِ رگرسیونِ چندکی هم روش و هدفِ دیگری دارد و صرفاً نامِ بازه، این فرمولها را قابلِ جایگزینی نمیکند.
برایِ سنجشِ عملیِ تحلیلِ تماس، واحدِ مشاهده، مرجع و خروجیِ موردِ انتظار را در درخواستِ بررسیِ اپرابین مشخص کنید. این راهنما اجرایِ قابلیتِ آماریِ مشخص در محصول را ادعا نمیکند؛ تمرین، برایِ روشنکردنِ هدفِ بازه است.
فایل تمرین و منبع
برازشِ واقعیِ خط و دو بازه با واریانسِ معلومِ فرضی · میانگین، h، دو واریانس و بازهها در مرکز و بیرونِ دامنه
- مستندِ رسمی؛ هدفِ میانگین و مشاهدهٔ تازه در خروجیِ پیشبینی
- کدِ رسمی؛ se_obs، جمعِ دو واریانس و انتخابِ توزیعِ نرمال یا t؛ کتابخانه اجرا نشده است
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.