
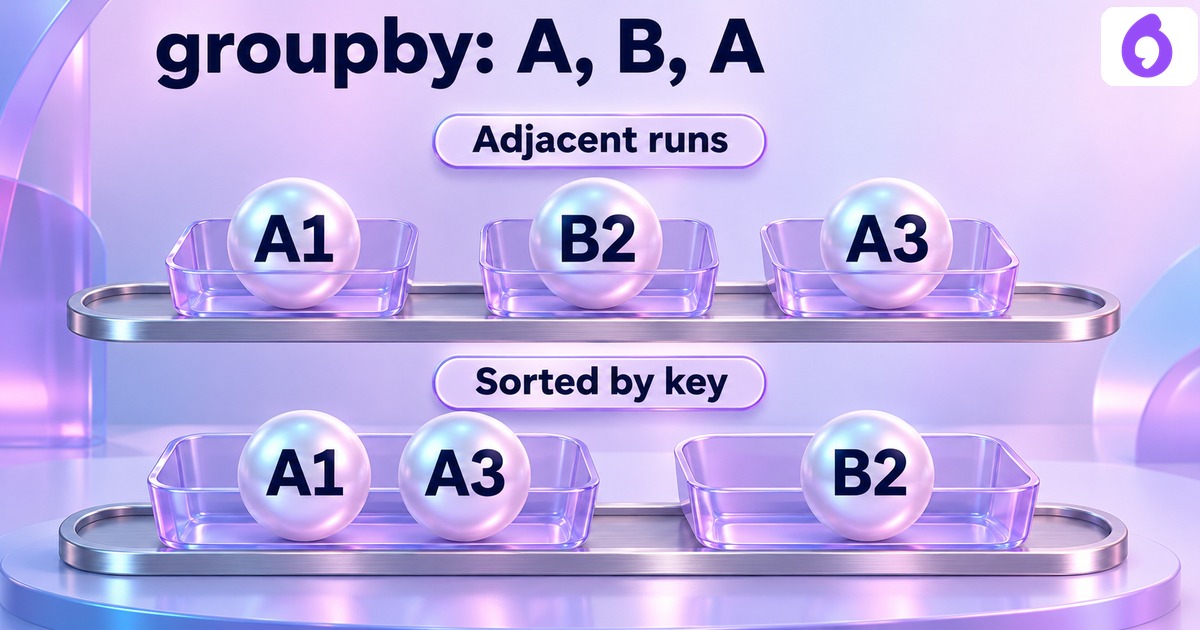
itertools.groupby در پایتون کلیدهای برابرِ متوالی را گروه میکند. اگر یک کلید بعد از کلیدِ دیگری دوباره بیاید، گروهِ تازهای میسازد؛ این رفتار گروهبندیِ سراسریِ SQL نیست. مثالِ A،B،A نشان میدهد تبدیلِ سادهٔ گروهها به dict چگونه میتواند رکوردِ گروهِ نخست را از گزارش کنار بزند.
سه رکورد، سه گروه
رکوردها( A،۱)،( B،۲) و( A،۳) هستند؛ کلید رشته و عدد شناسهٔ یکتای رکورد است. groupby با همان ترتیب، سه بخشِ A:[۱]،B:[۲] وA:[۳] میدهد. دو بخشِ A بهطور خودکار یکی نمیشوند، چون در جریان کنارِ هم نیستند.
اگر گروههای materializeشده را با نامِ کلید به dict بریزیم، انتسابِ دومِ A مقدارِ قبلی را بازنویسی میکند و فقط[۳]میماند. خودِ دادهٔ اصلی حذف نشده؛ سازندهٔ dict یک نامِ تکراری را جایگزین کرده است. این شاهد را با خطایِ خواندنِ فایل یا رفتارِ مدل اشتباه نگیریم.
اگر هدف گروهِ سراسری است
ابتدا رکوردها را با همان تابعِ کلید مرتب و سپس گروهها را در لحظه به list تبدیل میکنیم. خروجی A:[۱،۳] وB:[۲]است. مرتبسازی با شناسه بهجای کلید، در همین نمونه ترتیبِ A،B،Aرا حفظ میکند و مشکلِ هدفِ سراسری را حل نمیکند.
oracleِ مستقل بدونِ groupby یک dictِ فهرستها میسازد و شناسهٔ هر رکورد را به کلیدِ خودش append میکند. تمام شناسهها و چندمجموعهٔ رکوردها در دو خروجی برابرند. ترتیبِ کلیدهای نمایشی و حفظِ ترتیبِ داخلِ گروه قراردادهای جدا هستند؛ از برابریِ گروهها، ترتیبِ اولیهٔ کلِ جریان نتیجه نمیشود.
گروهِ برگشتی به منبعِ مشترک وصل است
در آزمایشِ A،A،B،B، ابتدا گروهِ A را میگیریم و بدونِ ذخیرهکردنِ اعضایش، iterator بیرونی را تا گروهِ B جلو میبریم. خواندنِ گروهِ قدیمیِ A اکنون فهرستِ خالی میدهد. این رفتارِ منبعِ مشترک، در مستنداتِ groupby نیز تصریح شده است.
در اجرایِ جدا، پیش از جلورفتن، اعضای A را list میکنیم. آن فهرستِ مستقل پس از رفتن به B باقی میماند. نگهداشتنِ خودِ group iterator با ذخیرهکردنِ محتوای آن یکی نیست؛ اگر بعداً اعضا را لازم دارید، زمانِ مصرف بخشی از طراحی است.
آزمونِ متوالی و آزمونِ سراسری را جدا کنیم
oracleِ دوم با یک حلقهٔ ساده، تغییرِ کلید را تشخیص میدهد و طولِ بخشهای متوالی را میسازد. آن را با نتیجهٔ groupbyِ بدون مرتبسازی مقایسه میکنیم. oracleِ dictِ appendشونده نیز نتیجهٔ سراسریِ پس از مرتبسازی را کنترل میکند؛ دو انتظارِ متفاوت را به یک oracle تحمیل نکردهایم.
همهٔ۱۲۷دنبالهٔ دوکلیدی با طولِ صفر تا۶اجرا شدهاند. در هر مورد، اعضا و شناسههای خروجی بررسی میشوند. این پوششِ جهانِ محدودِ تعریفشده است، نه تضمینِ همهٔ نوعهای کلید یا مجموعههای بسیار بزرگ. ورودیِ خالی هم خروجیِ خالی دارد.
از گروهبندی، حذفِ تکرار نتیجه نگیریم
دو رکوردِ همکلید میتوانند هر دو لازم باشند. این کد آنها را ادغامِ معنایی یا deduplicate نمیکند؛ فقط عضوهای گروه را نگه میدارد. پروفایلِ CSV شمارشِ ستون و تکثیرِ JOIN دانهبندیِ دیگری را بررسی میکنند.
چهار آزمون، شناسهٔ بولین، شناسهٔ تکراری، کلیدِ نامعتبر و بیش از۱۶رکورد را رد میکنند. مرتبسازیِ سراسری حافظه دارد و برای جریانِ بیپایان راهحلِ فوری نیست. مصرفِ iterator را نیز جدا بخوانید. اجرا با Python۳٫۱۲٫۱۴ و کتابخانهٔ استاندارد است؛ Pandas،SQLیا فایلِ مشتری اجرا نشدهاند. ادامه در مبانی هوش مصنوعی؛ این خطا به سامانهٔ اپرا نسبت داده نمیشود.
فایل تمرین و منبع
کد مستقل تمرین و تمام کنترلها؛ Python · ورودی و تمام نتایج اجرای واقعی؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.