
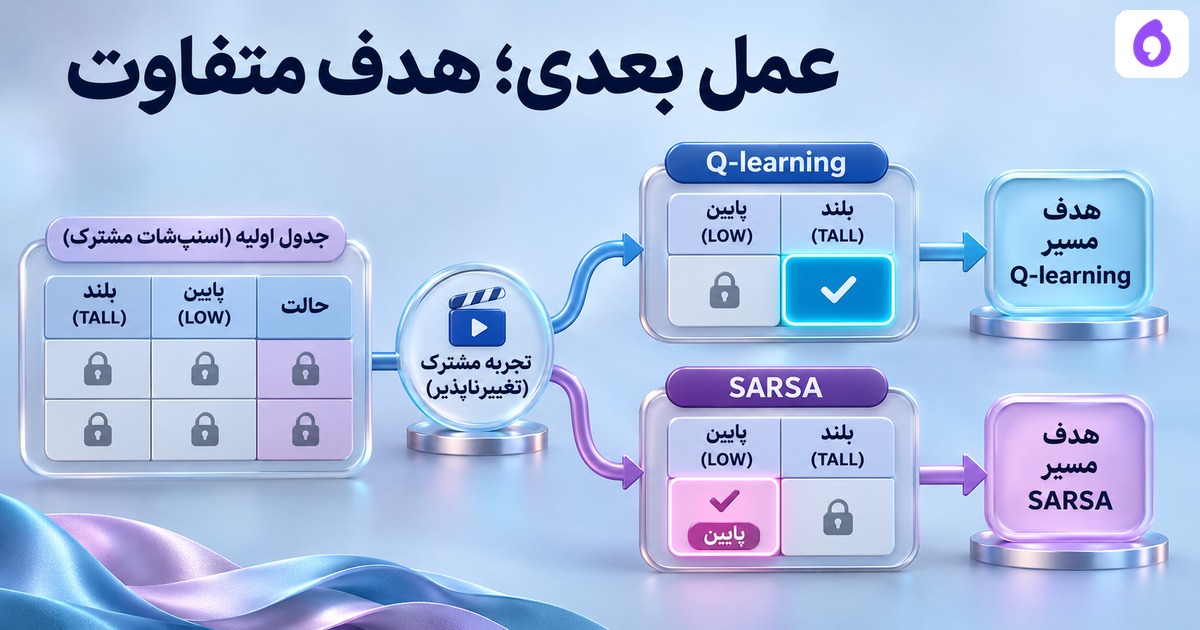
Q-learning و SARSA در ساختِ هدفِ اصلاحِ جدول فرق دارند: Q-learningبه بیشترینِ تخمینِ ردیفِ بعدی نگاه میکند؛ SARSAبه مقدارِ عملِ بعدیِ انتخابشده توسطِ رفتار. اگر آن عمل بهترینِ تخمینِ جدول نباشد، هدفها میتوانند متفاوت شوند. اینجا همان تجربه و همان snapshotِآغازین را با دو انتخابِبعدی واقعاً به دو تابعِبهروزرسانی میدهیم.
کدام بخشِ تجربه در هر دو آزمون ثابت است؟
دو وضعیتِStartوForkو جدولِساختگی داریم. درStart، مقدارِwaitبرابرِ۳وsendبرابرِ۱است. درFork، steadyمقدارِ۲وriskyمقدارِ۸دارد. تجربه میگوید ازStartباwait، پاداشِ−۲گرفته وبهForkرسیدهایم. نامِriskyبهتنهایی معیارِواقعیِخطر نیست؛ این دو اسم فقط شناسهاند.
نرخِاصلاحα=۱÷۵وضریبِتنزیلγ=۱÷۲است. درآزمونِاول، عملِبعدیِرفتار راsteadyاعلام میکنیم، بااینکه بیشترینِQِردیف،riskyاست. انتخابِرفتار دراین تمرین دستی است؛ قرعهٔε-greedy، محیطِواقعی یا حلقهٔاکتشاف اجرا نشده است. «انتخابشده» یعنی همان عملِثبتشدهٔسناریو که به تابع دادهایم، نه حدسِپنهانِتابع ازرویِmax.
هدفِ Q-learning مستقل ازاین انتخابِرفتاری است
بیشترینِQدرForkبرابرِ۸است. بنابراین target=−۲+۰٫۵×۸=۲، اختلافِTDبرابرِ۲−۳=−۱و مقدارِتازه۳+۰٫۲×(−۱)=۲٫۸یا۱۴÷۵میشود. bootstrapِاین قاعده ازriskyبا تخمینِ۸آمده، حتی وقتی درسناریو steadyبرایِعملِبعدی ثبت شده است.
SARSA همان عملِاعلامشده را میخواند
برایِsteady، مقدارِردیفِبعدی۲است؛ target=−۲+۰٫۵×۲=−۱وTD=−۱−۳=−۴. مقدارِتازه۳+۰٫۲×(−۴)=۲٫۲یا۱۱÷۵میشود. تفاوت ازپاداش، نرخ یا جدولِمتفاوت نیامده؛ فقط مرجعِبخشِآینده عوض شده است. برنامه نامِعمل وQِخواندهشده را کنارِهدف ثبت میکند تا علت قابلِردیابی بماند.
| عملِبعدیِسناریو | قاعده | Qِآیندهٔاستفادهشده | target | new ازold=۳ |
|---|---|---|---|---|
| steady | Q-learning | ۸، بیشترینِردیف | ۲ | ۱۴÷۵ |
| steady | SARSA | ۲، خودِsteady | −۱ | ۱۱÷۵ |
| risky | Q-learning | ۸ | ۲ | ۱۴÷۵ |
| risky | SARSA | ۸، خودِrisky | ۲ | ۱۴÷۵ |
انتخابِدوم چه چیزی را روشن میکند؟
عملِبعدی را این بارriskyاعلام میکنیم، ولی جدول و بخشِگذشتهٔتجربه را عوض نمیکنیم. Q-learningدوباره۱۴÷۵میدهد؛ SARSAهم چون عملِواقعاًاعلامشده همانmaxاست به۱۴÷۵میرسد. پس متفاوتبودنِنامِدو الگوریتم الزاماً متفاوتبودنِعددِهر updateرا نمیسازد. اختلاف وقتی آشکار شد که عملِرفتار غیرmaxبود.
چهار ردیف، چهار آزمایشِجدا ازیک جدولِثابتاند، نه چهار بهروزرسانیِپیاپی. تابع ازجدول کپی میگیرد و فقط خانهٔStart/waitرا اصلاح میکند؛ همهٔخانههایِدیگر و خودِsnapshotِورودی دقیقاً ثابت کنترل میشوند. کد ازFractionاست وگردکردن علتِاختلافِدو نتیجه نیست.
On-policy وoff-policy را به برتری تعبیر نکنیم
SARSAدرهدفِنمونهایِخود ازعملِبعدیِسیاستِرفتار استفاده میکند وازاین جهت on-policyاست. هدفِQ-learningبه بهترینِتخمینِجدول برایِمرحلهٔبعد وابسته است وازانتخابِغیرحریصانهٔهمین نمونه مستقل میماند؛ این تمایزِoff-policyدراین سطح است. هیچکدام صرفِنامش، «امنتر»، «دقیقتر» یا مناسبِهمهٔکارها نمیشود.
این صفحه آموزشِچنددورهای، حدِهمگرایی یا مقایسهٔکاراییِسیاست اجرا نکرده است. تخمینِ۸هم پاداشِقطعیِآینده نیست؛ عددِجدولِفرضی است. اگر رفتار یا داده یا فرضِپایان عوض شود، طراحیِآزمایش وشرایطِروش را جدا بررسی کنید.
پایانِواقعی و نبودِعملِبعدی
درآزمونِپایانیِمستقل، تجربه واقعاًterminalاعلام میشود. هر دو روش هدفِپاداشِ−۲را بدونِbootstrapمیگیرند و ازold=۳بهnew=۲میرسند. دراین حالت حتی ردیفِبعدی یا عملِبعدی لازم نیست. ولی درحالتِادامهدار، SARSAبدونِعملِبعدیِاعلامشده خطا میدهد و پنهانی آن را باmaxجایگزین نمیکند؛ این آزمونِمنفی هم واقعاً اجرا شده است.
برایِمرزِپایان با قطعِخارجی و محاسبهٔتکخانه، راهنمایِبهروزرسانیِQ را بخوانید؛ مسئلهٔاین صفحه مقایسهٔاثرِعملِرفتاری بود. وضعیت،عمل وپاداش پیشنیازِتعریفِتجربه است. درنیازِپاسخگویی وپیگیری، کارِمجاز وشاهدِپذیرش را در راهکارهایِاپرا مشخص کنید؛ این مثال آموزشِداخلیِمحصول را اعلام نمیکند.
فایل تمرین و منبع
دو عملِ بعدی، دو قاعده و یک snapshotِ ثابت؛ Python · شش دفترِ old/target/TD/new با عملِ منبع و خانههایِ ثابت
- Berkeley CS188؛ بخشِQ-Learning، targetِmax وبهروزرسانیِنمونهای
- منبعِاصلیِدورهٔBerkeley، پاییز۲۰۱۲؛ فقط سؤال۶ و فرمولِSARSA وفرقِسیاستِرفتار خوانده شد، نه همهٔآزمون
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.