
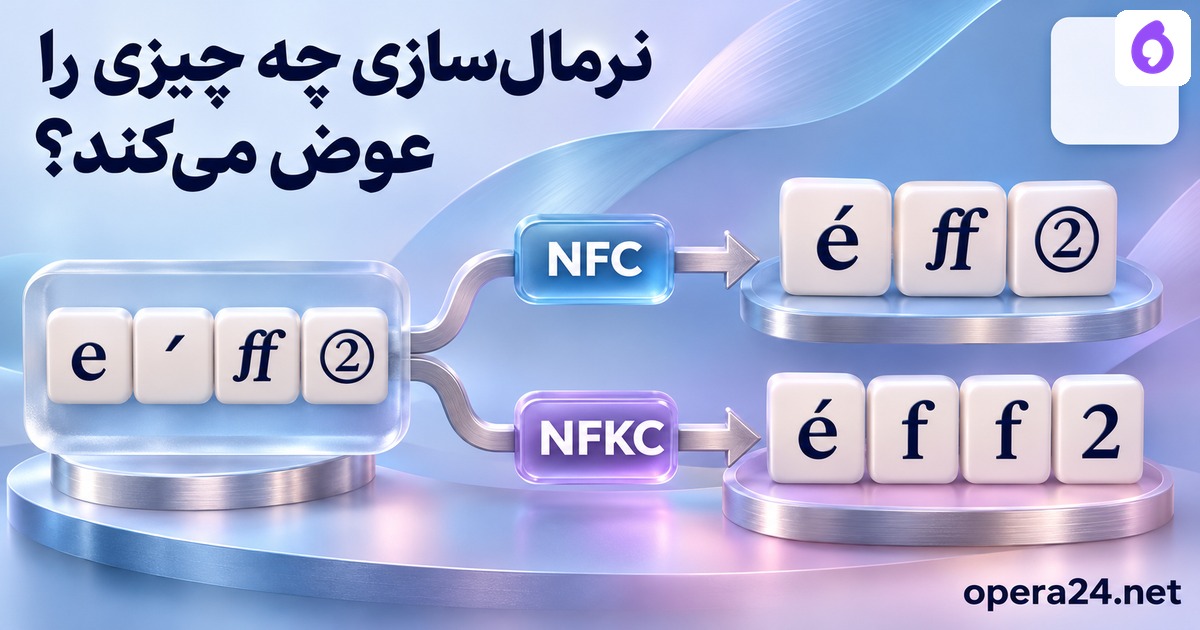
NFCوNFKCهر دو نرمالسازیِUnicodeهستند،اما یک نوعِ تفاوت را از بین نمیبرند. NFCبر همارزیِcanonicalتکیه دارد؛NFKCتمایزهایcompatibilityرا هم میتواند عوض کند. پیش از انتخاب،متن وcodepointهای قبل و بعد را روی نمونهٔ خودتان ببینید. این تمرین چهار فرم را روی نه رشتهٔ اصیل اجرا میکند و اصلِ متن را نگه میدارد.
ترکیبِ دو نویسه با اصلاحِ زبان یکی نیست
حرفِ لاتینِéمیتواند بهصورتِ یکcodepointیاeبهعلاوهٔعلامتِacuteنوشته شود. در نمونهٔ ما NFCدو صورت را برابر میکند وNFDصورتِ تجزیهشده را میدهد. نمونهٔ عربیِ«ا»بهعلاوهٔhamza aboveهم باNFCبه«أ»میرسد. این تبدیلِ اعلامی از تعریفِUnicodeمیآید،نه تشخیصِ منظورِ جمله.
در مقابل،«ی»فارسی و«ي»عربی در هر چهار فرمِ این اجرا متفاوت میمانند. نگاشتِ خاصِ فارسی،مانند تبدیلِ آن دو به یک کدِ منتخب،قاعدهٔ جداست؛نباید بیاعلان به حسابِ NFCیاNFKCگذاشته شود. نیمفاصلهٔ«میرویم»هم در تمامِ فرمهای نمونه باقی مانده است؛نرمالسازی را حذفِ عمومیِ نویسهها نمینامیم.
چهار فرم را روشن نام ببریم
| فرم | نوعِ تبدیلِ مبنا | رفتارِ کلی |
|---|---|---|
| NFD | canonical | تجزیه |
| NFC | canonical | تجزیه،سپس ترکیبِ مجاز |
| NFKD | compatibility | تجزیهٔسازگاری |
| NFKC | compatibility | تجزیهٔسازگاری،سپس ترکیب |
UAX#15تعریفِ این فرمها و تفاوتِ دو همارزی را توضیح میدهد. صفحهٔ دیدهشده Unicode۱۸،revision۵۸با تاریخِ۱۲اوت۲۰۲۶است. اجرایِ خودِ ماPython۳٫۱۲٫۱۴باپایگاهِUnicode۱۵٫۰٫۰است؛خواندنِ استانداردِ جدید را به معنیِ پیادهسازیِ نسخهٔ۱۸در runtimeمعرفی نمیکنیم.
تمایزهایی که NFKCتغییر میدهد
لیگچرِffدرNFCهمان یکcodepointمیماند،اماNFKCآن را به دوfتبدیل میکند. رقمِ دایرهدارِ② به رقمِ لاتینِ 2 با کدِ U+0032 و NBSPمیانِAوBبهSPACEمعمولی تبدیل میشود. در یک بافت این تغییر برای جستوجو مطلوب است؛در بافتِ دیگر،از دسترفتنِ تمایزِ نمایشی یا شکستنِ قراردادِ خطشکنی میتواند مهم باشد.
فایلِ نتیجه برای هر رشته،صورتِescapeشده،فهرستِکدها،هشِ اصل و خروجیِ هر فرم را دارد. از روی شباهتِ فونت قضاوت نمیکنیم؛کمشدنِ تعدادِcodepointهم لزوماً بهبودِ متن نیست. یک برچسبِ «تمیز شد»جزئیاتِ از دسترفته را نشان نمیدهد.
برگشتِ دقیق همیشه ممکن نیست
در آزمونِ جدا،«ff»و«ff»دو ورودیِ متفاوتاند که پس ازNFKCهر دوffمیشوند. از نتیجهٔ مشترک نمیتوان دانست کدام اصل را داشتهایم. بنابراین کد،تبدیل را روی نسخهٔ کاری اجرا و دادهٔ اصلی را ثابت نگه میدارد؛تابعِ معکوسِ حدسی تولید نمیکند.
اگر برای شناسه،امضا یا گزارش نیاز به بایتِ دقیقِ ورودی دارید،قراردادِ نرمالسازی باید پیش از مصرفِ بعدی معلوم باشد و نسخهٔ اصلی از بین نرود. برابریِ متنِ نرمالشده،تعلقِ شناسه به یک فرد یا برابریِ معنایِ دو عبارت را ثابت نمیکند. این تمرین اعتبارسنجِ هویت یا ابزارِ امنیتی نیست.
دوبارهاجراکردن چه میکند؟
برای نه نمونه و چهار فرم،۳۶تبدیل اجرا شدهاند. هر نتیجه دوباره با همان فرم نرمال میشود و باید ثابت بماند؛این idempotenceِهمان تبدیل در همین runtimeاست. متنِ خالی هم در هر چهار فرم خالی میماند. این آزمونِ کوچک،مجموعهٔ کاملِconformanceیا همهٔ نویسههای نسخهٔ جدید را پوشش نمیدهد.
نمونهها شاملِ حرفِ ترکیبی،حرفِ ازپیشترکیبشده،لیگچر،رقمِ دایرهدار،NBSPو دو صورتِی و نیمفاصلهاند. هیچ فایلِ خصوصی خوانده،بازنویسی یا ارسال نمیشود. کد فقط کتابخانهٔ استاندارد میخواهد و اصلِ بایتهای هر رشته را قبل و بعد مقایسه میکند.
با شمارش و امتیازِ گفتار فرق دارد
شمارشِ کاراکتر طول را در واحدهای متفاوت گزارش میکند؛این صفحه پیش و پسِ یک تبدیلِ مشخص را میسنجد. در WERفارسی،نگاشتِی وک و رقمها قواعدِ اضافهٔ ارزیابیاند؛همهٔ آنها NFCنیستند و تغییرِ امتیاز هم آزمایشِ بهبودِ مدل نیست.
برای بررسیِ متنِ خروجیِ اپرانگار،قراردادِ نگارش و حفظِ اصل را همراهِ نمونهٔ مجاز مطرح کنید. این راهنما قاعدهٔ داخلیِ محصول را اعلام نمیکند. تصمیمِ نرمالسازی باید با نیازِ نمایش،مقایسه و نگهداریِ متن سازگار باشد؛نه اینکه همهٔ رشتهها صرفاً با یک دکمه بیتوضیح عوض شوند.
فایل تمرین و منبع
کدِ کاملِ محلیِ تمرین و کنترلهایش · دادهٔ اصیل و نتیجهٔ اجرای واقعی؛ نویسههای کنترلی escape شدهاند
- UAX#15،Unicode۱۸revision۵۸،۱۲اوت۲۰۲۶؛بخشهای۱٫۱و۱٫۲واقعاً خوانده شد،نه همهٔ استاندارد
- مستندِPython۳٫۱۲،normalizeوunidata_version؛اجرایِواقعیUCD۱۵است،نه آزمونِ انطباقِUnicode۱۸
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.