
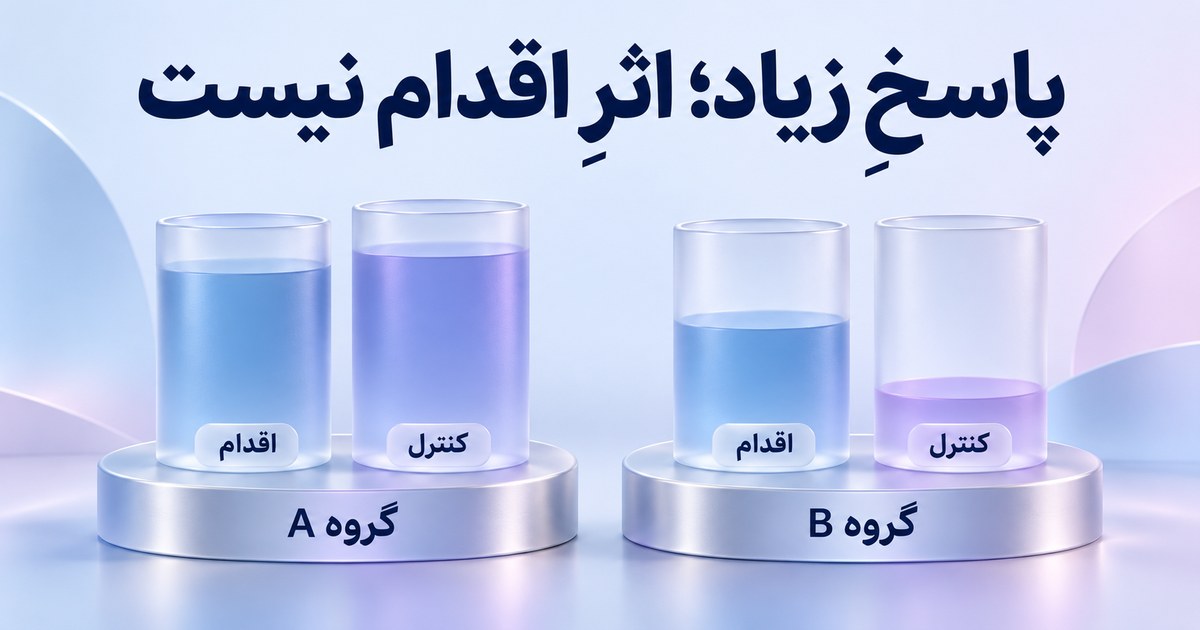
مدلِ Uplift به تفاوتِ نتیجه با اقدام و بدونِ اقدام توجه دارد؛ احتمالِ پاسخدادن پس از اقدام بهتنهایی همان اثر نیست. یک گروه میتواند حتی بدونِ اقدام پاسخِ زیادی داشته باشد. برایِ دیدنِ این تفاوت، دو مدلِ میانگینِ گروهی را رویِ هشتاد ردیفِ کاملاً ساختگی برازش میدهیم و ترتیبِ نرخِ پاسخ را با ترتیبِ اختلاف مقایسه میکنیم.
اقدام و گروهِ کنترل را صریح تعریف کنیم
در تمرین، دو گروهِ خیالیِ A و B و یک اقدامِ دودویی داریم. نامِ گروهها ویژگیِ حساس یا بخشِ واقعیِ مشتریان نیست. برایِ هر گروه، بیست ردیفِ با اقدام و بیست ردیفِ بدونِ اقدام میسازیم. نتیجه فقط صفر یا یک است؛ معنایِ آن موفقیتِ آموزشیِ یک کارِ فرضی است و سفارش، فروش یا تماسِ واقعی نیست.
نویسنده تعدادِ موفقیتها را تعیین کرده است: در A، هجده موفقیت با اقدام و نوزده بدونِ اقدام؛ در B، هشت موفقیت با اقدام و دو بدونِ اقدام. کد ردیفها را با شناسهٔ یکتا تولید میکند. تخصیصِ تصادفی، آزمایشِ واقعی یا نمونهگیری از جمعیت انجام نشده است؛ این جدول شاهدِ اثرِ علّی در جهانِ واقعی نیست.
دو مدلِ ساده را واقعاً برازش دهیم
مدلِ نخست فقط ردیفهایِ بدونِ اقدام و مدلِ دوم فقط ردیفهایِ با اقدام را میبیند. هر مدل برایِ A و B میانگینِ نتیجهٔ مشاهدهشده را از ردیفهایِ خودش حساب میکند. این نسخهٔ بسیار محدود، دو جدولِ میانگین است؛ جنگل، شبکه یا کتابخانهٔ CausalML اجرا نمیکند و برایِ گروهِ ندیده مقدارِ معتبر اختراع نمیکند.
| گروه | میانگینِ با اقدام | میانگینِ کنترل | اختلافِ مشاهدهشده |
|---|---|---|---|
| A | ۱۸/۲۰ = ۰٫۹ | ۱۹/۲۰ = ۰٫۹۵ | منفیِ ۰٫۰۵ |
| B | ۸/۲۰ = ۰٫۴ | ۲/۲۰ = ۰٫۱ | ۰٫۳ |
اگر فقط میانگینِ با اقدام را رتبهبندی کنیم، A جلو میافتد. اگر اختلافِ دو مدل را رتبهبندی کنیم، B جلو است و A اختلافِ منفی دارد. هر دو ترتیب از اجرایِ همان کد آمدهاند؛ بالا بودنِ پاسخِ A بهتنهایی نشان نمیدهد اقدام به آن کمک کرده است.
از اختلافِ شرطی تا اثرِ علّی
در چارچوبِ T-Learner، هدفِ اثرِ شرطی با تفاوتِ دو میانگینِ نتیجهٔ بالقوه بیان میشود. برایِ تفسیرِ میانگینهایِ مشاهدهشده بهعنوانِ آن هدف، طرحِ تخصیص و فرضهایی مثلِ نبودِ مخدوشگرِ بازِ مربوط، مثبتبودنِ احتمالِ دو حالت و تعریفِ ثابتِ اقدام لازماند. فایلِ دستسازِ ما آنها را برایِ دادهٔ واقعی تأیید نمیکند.
برایِ هر ردیف، فقط نتیجهٔ همان حالتِ مشاهدهشده داریم؛ دو نتیجهٔ بالقوهٔ یک فرد را ندیدهایم. اختلافِ گروهی را «اثرِ قطعیِ این فرد» نمینامیم. همچنین اگر یک واحد چند بار در داده باشد یا اقدامِ یک نفر بر دیگری اثر بگذارد، استقلال و واحدِ ارزیابی باید جدا بررسی شوند.
چه چیزی با این جدول مشخص نمیشود؟
بازهٔ اطمینان، توانِ آزمون، Qini، معیارِ سیاست یا کیفیت رویِ جمعیتِ جدا حساب نشده است. چهار خانهٔ بیستردیفی، تعدادِ لازمِ عمومی برایِ یک آزمایش نیستند. اختلافِ منفیِ آموزشی هم دستورِ حذفِ مشتری یا جلوگیریِ خودکار از ارتباطِ واقعی نیست؛ اقدامِ عملی به مجوز، ارزشِ خروجی و پیامدِ خطا نیاز دارد.
منبعِ اصلی، چارچوبِ دو مدل و هدفِ CATE را توضیح میدهد؛ نتیجههایِ پژوهش یا عملکردِ یک ابزار را به این فایل منتقل نکردهایم. عبارتِ «دو مدل» در اینجا همان دو جدولِ میانگینِ برازششده است؛ مدلِ یادگیریِ پیچیده یا نتیجهٔ فروشِ بهتر ادعا نشده است.
تفاوت با دو سؤالِ نزدیک
مثالِ متغیرِ مخدوشگر نشان میدهد جمعکردنِ گروهها چگونه جهتِ رابطه را عوض میکند؛ اینجا نرخِ پاسخِ پس از اقدام را با اختلافِ دو نتیجه جدا کردیم. انتخابِ آستانه با هزینهٔ خطا نیز هدفِ تصمیمِ دیگری دارد و خودِ اثرِ اقدام را از نرخِ پاسخ استخراج نمیکند.
اگر نیازِ شما پیگیریِ مشتری است، ابتدا اقدامِ مجاز، نتیجهٔ قابلِ مشاهده و مسیرِ ارجاع را در راهکارهایِ اپرا روشن کنید. این تمرین نه تماس میگیرد، نه تجربهٔ مشتری میسازد و نه وجودِ مدلِ Uplift در اپرا را اعلام میکند.
فایل تمرین و منبع
دو مدلِ میانگینِ گروهی را از هشتاد ردیفِ ساختگی برازش دهید · نرخِ پاسخِ با اقدام، کنترل و ترتیبِ متفاوتِ اختلافها
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.